Análise da Invisible Work
Quem conta os tokens que você paga? A fatura de IA que ninguém consegue conferir
Pensar custa caro, e quem paga a fatura de IA da empresa, CEO ou CFO, não consegue auditar o que comprou: a unidade é do vendedor e a quantidade de “pensamento” é decidida pelo modelo. Nos modelos de IA que raciocinam, a documentação da OpenAI diz que os tokens de raciocínio não aparecem na resposta e são cobrados como saída, e a da Anthropic orienta acompanhar quantos dos tokens cobrados foram raciocínio interno. Dois artigos de maio de 2025 mostram que a cobrança por token cria para o provedor o incentivo de errar a contagem e deixa o usuário sem prova, e o CTO da CloudZero diz, em palestra de outubro de 2026, que nem ele confia por inteiro na própria fatura. Nenhuma fonte lida mostra um provedor inflando a contagem. A leitura corrente trata o custo de IA como problema de volume. A premissa escondida: gerir custo supõe que a quantidade é um fato que você confere, e aqui o vendedor define a unidade e o modelo decide a quantidade. Uma leitura da Invisible Work, com o conceito de bem de crença (Darby e Karni, 1973), sobre por que o preço por token não compara contratações e uma régua de custo por resultado aceito em quatro decisões.
Gustavo Bodra12 min de leitura
Parte 1 / Entenda os dados
O que a fatura de IA mede, e o que fica fora do que você consegue ler?
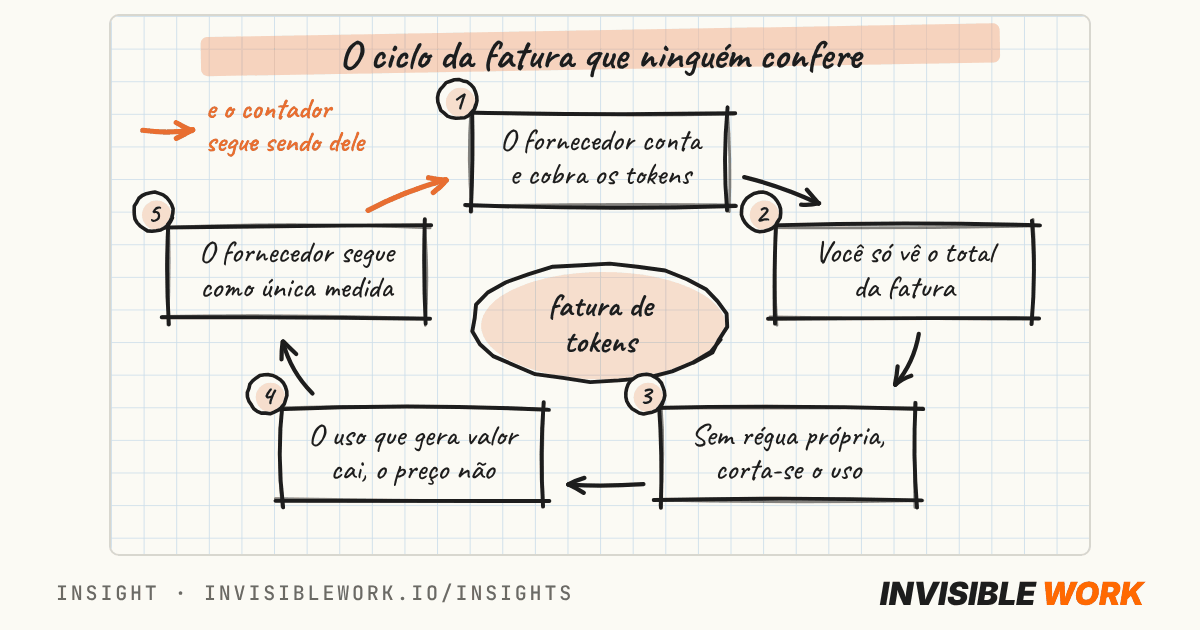
Pensar custa caro, e quem paga a fatura de IA não consegue auditar o que comprou. Nos modelos que raciocinam, a documentação dos provedores diz que o texto de raciocínio não aparece na resposta, mas é cobrado como saída: CEO ou CFO aprovam um total cuja quantidade o vendedor conta e ninguém lê. Pesquisadores mostraram que esse desenho dá ao vendedor um incentivo para errar a contagem e a você nenhuma prova. Nenhuma fonte lida mostra um provedor fazendo isso, e a tese não precisa de má-fé: mesmo com um vendedor honesto, você não separa o que subiu porque a sua equipe usou mais do que subiu porque o modelo pensou mais ou porque a unidade mudou. A saída é uma régua própria, um conjunto fixo de tarefas medido todo mês, que devolve a quem paga a conta um número que o vendedor não escreve. [1] afirmação da fonte original[2] afirmação da fonte original[4] afirmação da fonte original[5] afirmação da fonte original
Em palestra no QCon AI, publicada pelo InfoQ em 12 de outubro de 2026, Erik Peterson, fundador e CTO da CloudZero, empresa que vive de analisar custo de nuvem e de IA, disse que não consegue confiar por inteiro nem na própria fatura. Segundo ele, a conta de IA voltou ao formato da conta de luz: 10.000 quilowatts-hora, um milhão de tokens, sem saber se a luz ficou acesa ou se o forno ligou. Ele afirma que ninguém concorda com a unidade, que cada fornecedor usa fórmulas e termos próprios, e que quando um fornecedor muda o jeito de dividir o texto em tokens, o custo sobe 35%, e que nada disso está sob controle do cliente. [1] afirmação da fonte original
A documentação dos dois maiores provedores confirma a parte que importa. A da OpenAI diz que os tokens de raciocínio não são visíveis pela interface de programação, ocupam espaço na janela de contexto e são cobrados como tokens de saída, e que os modelos podem gerar de poucas centenas a dezenas de milhares deles dependendo da complexidade. O número exato aparece no registro de uso da resposta. Conforme o modelo, os níveis de esforço de raciocínio vão de nenhum a máximo, e os modelos também raciocinam de forma adaptativa. [2] afirmação da fonte original A da Anthropic orienta acompanhar um campo do registro de uso que informa quantos dos tokens de saída cobrados foram raciocínio interno. [3] afirmação da fonte original Ou seja, a contagem é informada pelo provedor, o conteúdo não é entregue, e quem decide quanto raciocínio acontece em cada chamada é, em boa parte, o próprio modelo.
- Sucesso máximo do auditor CoIn
- 94,7%
- Taxa máxima com que o CoIn, auditor proposto por pesquisadores em maio de 2025, detectou inflação na contagem de tokens de raciocínio, nos experimentos dos próprios autores. Mede a eficácia do auditor, e não quantos provedores inflam.
- Aumento de custo citado por Peterson
- 35%
- Quanto o custo em tokens subiu, segundo a palestra, quando um provedor mudou a forma de dividir o texto em tokens. O número é da fala dele, e a palestra não nomeia o provedor nem o modelo.
- Provedores que as fontes lidas mostram inflando a contagem
- 0
- Os artigos mostram que o desenho de cobrança cria o incentivo e a vulnerabilidade. Nenhum deles, nem a palestra, apresenta um caso de provedor que tenha inflado a contagem.
Termos deste texto, em uma frase
Parte 2 / O que a leitura corrente não vê
Por que a fatura de IA é um bem de crença, e quem mede o que você paga?
A leitura corrente trata o custo de IA como um problema de volume: o token ficou mais barato, o uso explodiu, então controle quem usa, quanto e com qual modelo. É um bom conselho e é o que a maior parte do FinOps de IA faz. Em primeiros princípios, a pergunta vem antes: o que você compra em qualquer fornecimento medido é preço vezes quantidade, e a gestão de custo supõe que a quantidade é um fato que você consegue conferir. Na energia, no combustível e nas horas de um consultor, consegue. Na fatura de IA, a quantidade tem três características que a tornam outro tipo de compra.
Primeiro mecanismo: quem vende decide quanto você precisa
Em 1973, Michael Darby e Edi Karni descreveram os bens de crença: aqueles em que o vendedor sabe o que o cliente precisa, entrega e cobra o serviço, e o cliente não consegue conferir nem depois. O exemplo clássico é a oficina que diagnostica e conserta o mesmo carro. [6] afirmação da fonte original Num modelo que raciocina, o desenho é parecido: o modelo decide, a cada chamada, quanto raciocínio gastar, o provedor conta e cobra, e o conteúdo não é entregue. Você controla o esforço máximo e o limite de tokens, e dentro deles a quantidade é do modelo.
Segundo mecanismo: a unidade é do vendedor
Uma quilowatt-hora é a mesma em qualquer distribuidora. Um token não é: depende do tokenizador do modelo. Por isso o preço por milhão de tokens de dois modelos não é comparável sem saber quantos tokens cada um gasta para a mesma tarefa, e por isso uma troca de tokenizador pode mexer na fatura sem mexer em uma linha do que a sua equipe faz. Peterson relata exatamente isso, com o aumento de 35% que ele atribui à mudança. [1] afirmação da fonte original
Terceiro mecanismo: o incentivo existe, e a prova não
Ander Artola Velasco e colegas mostram que, na cobrança por token, o provedor tem incentivo financeiro para informar mais tokens do que o modelo usou, e que o usuário não consegue provar nem saber se foi cobrado a mais. Segundo os autores, se o provedor for obrigado a ser transparente sobre o processo de geração, errar a contagem sem levantar suspeita é difícil. E mostram, como demonstração, um algoritmo que sobrecarrega a conta sem levantar suspeita e custa menos do que rende. Para eliminar o incentivo, o preço teria de ser linear no número de caracteres. [5] afirmação da fonte original O CoIn, de Guoheng Sun e colegas, trata do raciocínio invisível: afirma que esses tokens muitas vezes respondem pela maior parte do custo, que o usuário não tem como verificá-los, e propõe um auditor independente que, nos testes dos autores, detecta inflação em até 94,7% dos casos. [4] afirmação da fonte original Os dois são trabalhos de maio de 2025 sobre o desenho do sistema. Não dizem que algum provedor infla, e este texto também não.
Onde a sociedade já resolveu isso
Quando o vendedor mede o que cobra, a regra é criar um terceiro. A bomba do posto e a balança do açougue passam por controle metrológico legal, e a lei que organiza o tema dá ao Inmetro a competência de regulamentá-lo para os instrumentos de medição. [7] afirmação da fonte original Nas fontes lidas não há nada equivalente para o contador de tokens: a proposta existente é um auditor de terceiros, em artigo acadêmico. Enquanto isso não existir, o medidor aferido tem de ser o seu.
Há ainda uma camada para quem recebe a IA dentro de outro produto. O ERP ou o sistema de atendimento que cobra por crédito ou por tarefa converte tokens em uma unidade própria, e a conversão é do fornecedor. O Insight sobre a cobrança por tarefa nos ERPs trata desse caso pelo lado do preço. Aqui a pergunta é a anterior: quem conta.
Parte 3 / A conta
Por que o preço por token não diz qual contratação é mais barata?
A conta que o decisor precisa ter na mão cabe em um tipo de chamada. O que vale é o custo de cada resultado aceito, e não o preço de cada milhão de tokens.
Exemplo hipotético: classificar 10.000 chamados por mês com dois modelos
Três lições saem da conta. A primeira: o preço por token só compara dois modelos que gastem o mesmo número de tokens, e isso quase nunca acontece. A segunda: o acerto entra na conta, porque resposta rejeitada é custo sem resultado (veja o Insight sobre o custo de provar). A terceira: o número que governa a decisão não está na fatura, e a empresa precisa produzi-lo.
A régua de 30 centímetros
O instrumento é simples. Escolha de 30 a 50 casos reais de um processo, com a resposta certa conhecida, rode todos com a mesma configuração todo mês e anote os tokens informados, o custo e quantos resultados foram aceitos. Se o custo por resultado aceito do mesmo conjunto mudar sem que você tenha mudado o pedido, a mudança veio de fora, do modelo, do esforço ou da unidade, e agora você tem um número para levar ao fornecedor. É a mesma lógica de um teste de avaliação de IA, que o guia sobre evals explica, aplicada ao custo.
Parte 4 / Primeira, segunda e terceira ordem
O que acontece com a empresa que aceita a fatura como está, e com a que mede por conta própria?
Cada degrau parte de um fato e pergunta “e depois?”.
Cadeia 1: a empresa que só lê o total da fatura
1ª ordem: a linha de IA cresce e o financeiro só enxerga o total
O custo é variável, vem em uma unidade do fornecedor e chega sem a explicação do que mudou. A conversa do mês vira “quem está usando demais”, porque é a única explicação que a fatura permite.
2ª ordem: a empresa corta o uso por pessoa e deixa o preço por resultado sem teste
Num relato do r/ExperiencedDevs, um engenheiro de uma grande empresa de tecnologia descreve duas faixas de gasto mensal com IA no time, uma na casa das centenas e outra na dos milhares, com a faixa alta gastando de 7 a 8 vezes mais e, segundo ele, sem diferença visível de produtividade. [8] afirmação da fonte original O relato é um só, mas mostra o ponto: o corte por pessoa atinge quem usa muito, sem separar quem usa bem. O custo por resultado, que decidiria, continua sem medida.
3ª ordem: o fornecedor vira a única medida de consumo, custo e qualidade, e a troca de modelo fica arriscada
Sem série própria, qualquer mudança de modelo, de esforço ou de tokenizador chega como fato consumado, e a empresa não sabe se o novo custo é pior. Depois de alguns anos, o fornecedor é a única fonte do número que você usa para negociar com ele.
Cadeia 2: a empresa que mede com uma régua própria
1ª ordem: uma variação de custo ganha causa, e a conversa com o fornecedor passa a ter número
Com o conjunto fixo de tarefas, a empresa separa o que mudou no uso do que mudou no modelo. A pergunta ao fornecedor deixa de ser “por que subiu?” e vira “o mesmo conjunto de tarefas custa mais desde setembro, o que mudou?”.
2ª ordem: cada tarefa vai para o modelo e o esforço que dão o menor custo por resultado aceito
Tarefas simples e de alto volume vão para modelos sem raciocínio ou com esforço baixo, e o raciocínio caro fica para as decisões em que o acerto paga. O orçamento passa a ser por resultado, e o limite de gasto por agente, tema do Insight sobre alçada, fica ancorado em um custo conhecido.
3ª ordem: a régua é portátil, e a empresa pode trocar de fornecedor sem perder o critério
O conjunto de tarefas e o critério de aceite são da empresa, e funcionam com qualquer provedor. A troca de fornecedor deixa de ser um salto no escuro, e o poder de barganha na renovação passa a vir de uma alternativa medida.
Parte 5 / O que fazer com isso
Como tirar a fatura de IA do escuro em quatro decisões?
O método cabe numa reunião de uma hora entre CEO, CFO, CTO e a área que mais usa IA, antes da próxima renovação ou da próxima contratação.
CFO: abra a fatura em linhas e dê um dono a ela
Peça ao fornecedor, ou ao seu sistema de registro, a divisão mensal entre tokens de entrada, saída visível e raciocínio, por processo. Qual parcela da saída é raciocínio que ninguém lê? Dê a uma pessoa a responsabilidade pelo número, como o Insight sobre limite de gasto de agentes recomenda para o consumo variável.
CTO: monte a régua e repita todo mês
Um conjunto de 30 a 50 casos reais por processo, resposta certa conhecida, mesma configuração, anotando tokens informados, custo e resultados aceitos. Registre o modelo, o esforço de raciocínio e a data. Guarde as séries na empresa, não no painel do fornecedor.
Compras e jurídico: escreva a unidade antes de assinar
Como o token é contado e quem avisa, com antecedência, uma mudança de modelo, de tokenizador ou de esforço padrão. Exportação de registro de uso com a divisão entre entrada, saída e raciocínio. Um limite mensal que exige sua aprovação para ser ultrapassado. Direito de auditar, ou de contratar quem audite, a contagem. Sem parecer jurídico aqui: é uma lista do que perguntar.
CEO: decida que resultado a empresa compra, e não que volume de IA
Troque a meta de uso por uma meta de custo por resultado aceito nos processos em que a IA já roda. Pergunte, a cada renovação, qual é o custo por resultado hoje e qual era há três meses. Sem isso, o orçamento de IA continua a ser uma aposta sobre um número que o fornecedor escreve.
Parte 6 / Limites
O que este texto não prova e o que o derrubaria?
As fontes mostram o que a documentação de dois provedores diz em outubro de 2026: raciocínio cobrado como saída, conteúdo não entregue por inteiro, contagem informada pelo provedor e níveis de esforço e raciocínio adaptativo. Mostram ainda o que dois artigos de maio de 2025 demonstram: que a cobrança por token cria o incentivo e a vulnerabilidade, e que um auditor independente funciona nos experimentos dos autores. A palestra é um relato de quem analisa contas de nuvem e de IA, e o número de 35% é dele. Nenhuma fonte lida mostra um provedor inflando a contagem, nem mede quanto da fatura típica de uma empresa média é raciocínio invisível. Os provedores podem ter mudado práticas depois de maio de 2025. Que a fatura seja um bem de crença, que a empresa não separe uso de preço sem uma medida própria, e que a régua de tarefas fixas resolva isso são leituras da Invisible Work. O exemplo hipotético usa valores inventados. A referência à metrologia legal é uma analogia e não um parecer jurídico.
A objeção mais forte é que o provedor tem marca, contratos e concorrência a perder, o registro de uso informa a contagem de cada chamada, e a maior parte do gasto de IA das empresas médias é assinatura por pessoa, que não tem esse problema. Está certa, e a tese não depende de má-fé: ela diz que, mesmo com vendedor honesto, a empresa só gerencia o que consegue medir. Para licenças por pessoa, a régua pesa menos; pesa mais quando a IA entra por API, por agente ou embutida em outro sistema e cobrada por crédito ou por tarefa. Uma segunda objeção: a régua custa tempo, e para gasto pequeno não compensa. Também está certa, e é por isso que a primeira decisão é abrir a fatura em linhas, para saber onde o gasto vale uma régua.
O que faria abandonar a tese: (1) um mecanismo de auditoria independente da contagem de tokens, aceito pelos principais provedores; (2) fatura com o conteúdo do raciocínio, ou com a contagem verificável por terceiros, e aviso prévio de mudanças de tokenizador e de esforço padrão; (3) recontagens independentes, em escala, mostrando que os números informados batem com o que os modelos geram.
Parte 7 / Perguntas para levar adiante
O que a sua empresa sabe sobre a própria fatura de IA?
Seis perguntas para o CEO, o CFO, o CTO e o CMO, antes da próxima renovação ou contratação de IA.
CEO e CFO: o número e o dono
- Quanto custa um resultado aceito nos processos em que a IA já roda, e quem na empresa responde por esse número?
- Que parcela da saída que a empresa paga é raciocínio que ninguém lê?
- A meta de IA da empresa é de uso ou de custo por resultado?
CTO e CMO: a régua e o contrato
- Existe um conjunto fixo de tarefas, rodado todo mês, que detecta uma mudança de custo vinda do fornecedor?
- O contrato obriga o fornecedor a avisar uma troca de modelo, de tokenizador ou de esforço padrão?
- O marketing e o atendimento também compram IA por crédito ou por tarefa, e alguém sabe converter isso em tokens?