Análise da Invisible Work
Como avaliar IA na empresa: o teste de quem decide tem teto
Quem decide o orçamento de IA costuma testá-la com perguntas curtas, 1,5 hora por semana em média, e esse teste tem teto: não distingue um chatbot gratuito de um sistema que trabalha por semanas. Andrej Karpathy descreveu em 11/10/2026 a distância como um funil, e uma pesquisa com quase 6.000 executivos mostra onde está quem decide. Uma leitura da Invisible Work, com efeitos de segunda e terceira ordem para a empresa brasileira e um teste de cinco perguntas.
Invisible Work11 min de leitura
Parte 1 / Entenda os dados
Com o que, e por quanto tempo, quem decide o orçamento de IA testa a IA?
Quem decide quanto a empresa investe em IA costuma testá-la com perguntas curtas, cerca de 1,5 hora por semana em média, e esse teste tem teto: uma pergunta de um parágrafo não distingue um chatbot gratuito de um sistema que trabalha sozinho por semanas. A estratégia acaba calibrada no ponto em que a diferença não aparece, enquanto o sinal está com poucos técnicos e com os fornecedores. Em 11 de outubro de 2026, o pesquisador Andrej Karpathy descreveu essa distância como um funil, e uma pesquisa com quase 6.000 executivos mostra em que parte do funil está quem assina o orçamento. [1] afirmação da fonte original[3] afirmação da fonte original
O pesquisador de IA Andrej Karpathy escreveu que a diferença no entendimento do que os modelos de linguagem fazem “está aumentando” e que já não são “dois grupos falando um por cima do outro”, e sim “um funil afiado” (tradução nossa). Pelas contas de guardanapo dele, cerca de 6 bilhões de pessoas (75% da população) quase não tiveram contato; 1 a 2 bilhões (20%) usam pouco o plano gratuito e veem “chatbots bobos”; cerca de 20 milhões (0,2%) usam sistemas de ponta profissionalmente em matemática e programação e veem projetos de semanas ou meses saírem de uma instrução; e cerca de 5.000 pessoas têm acesso a sistemas de ponta por dentro dos fabricantes. Sobre executivos, ele diz que passam muito tempo falando com outras pessoas e que “entendem intelectualmente o que está acontecendo, mas é de segunda mão e um pouco abstrato” (tradução nossa). [1] afirmação da fonte original
Os números de Karpathy não têm fonte, e ele os chama de estimativa de guardanapo. Já a pesquisa dos economistas Ivan Yotzov, Nicholas Bloom e outros 11 autores ouviu quase 6.000 executivos seniores (presidentes, diretores financeiros e gerentes financeiros seniores) de empresas dos Estados Unidos, do Reino Unido, da Alemanha e da Austrália, entre novembro de 2025 e janeiro de 2026. Perguntados sobre o uso pessoal de IA no trabalho, 28% disseram que não usam, 41% usam até 1 hora por semana, 24% de 1 a 5 horas e 7% mais de 5 horas, uma média de cerca de 1,5 hora. Em uma amostra separada de cerca de 3.000 trabalhadores americanos, a média foi de 1,8 hora. [3] afirmação da fonte original
- Uso pessoal de IA por executivos
- 1,5 hora
- Média por semana, segundo os próprios executivos (quase 6.000 em quatro países, de nov/2025 a jan/2026). Soma nossa: 69% usam até 1 hora por semana ou nada (28% mais 41%). É autodeclarado, e não mede para que usam nem com qual nível de ferramenta.
- Impacto passado visto por quem decide
- 9 em 10
- Fração de executivos que dizem não ter visto impacto da IA no emprego nem na produtividade da empresa nos últimos três anos. É o que eles declaram, não uma medição feita nas empresas.
- Previsão de emprego em três anos
- −0,7% × +0,5%
- Os executivos preveem que a IA reduza em 0,7% o emprego nas suas empresas (1,2% nas americanas); os trabalhadores americanos preveem aumento de 0,5% nas deles. São previsões médias para os próximos três anos, não resultados, e as duas amostras não são das mesmas empresas.
Termos deste texto, em uma frase
Parte 2 / O que a leitura corrente esconde
Por que “usar mais” não resolve, e por que os dois lados têm razão?
A leitura corrente divide o mundo em entusiastas e céticos. No Hacker News, o fio sobre o texto de Karpathy (234 pontos e 379 comentários) reproduz a divisão. Um comentário diz que “nerds” (programadores, matemáticos) veem como os modelos são bons no que lhes interessa e presumem que valerá para tudo, sem motivo para isso. Outro diz que o que funciona de fato são traduções e geração de código, em que as regras estão documentadas e o próprio código permite conferir o resultado. Outro, que já atingimos o “pico” do que a pessoa comum precisa. E há quem conteste que os 20 milhões vejam “projetos de meses feitos por uma instrução”: o desacordo, segundo outro comentário, é entre quem revisa o código e quem não revisa. [2] afirmação da fonte original
Os dois lados têm razão sobre a própria amostra, e é isso que a discussão esconde. A premissa embutida é que “a capacidade da IA” é um número que qualquer um mede com qualquer teste. Karpathy dá a chave em duas frases: “o impacto cresce com a ambição, o tamanho do problema e o horizonte”, e “uma pergunta com resposta de um parágrafo mal exige do sistema”. E acrescenta a irregularidade: a capacidade é maior onde o resultado é digital, verificável e economicamente valioso. [1] afirmação da fonte original O que um teste enxerga depende de quão difícil é a pergunta e de em qual tipo de tarefa ela cai.
A pesquisa de Bloom e coautores mostra o outro lado da mesma moeda. Mesmo com quase 70% dos executivos usando pouco, eles fazem previsões sobre os próximos três anos: mais produtividade (1,4% em média, e 2,3% nas empresas americanas) e menos emprego. [3] afirmação da fonte original Bloom diz à Fortune ter dúvida sobre quem está certo: os funcionários “são realistas” ou “provavelmente não veem o quadro completo”, e ele suspeita que os executivos “provavelmente estão mais certos”. [4] afirmação da fonte original Nada nas fontes mede quem acerta, e é exatamente esse o ponto: ninguém mediu com um teste capaz de separar.
A melhor objeção, e o que ela muda na tese (steelman)
Parte 3 / Primeiros princípios
E se o seu teste não tiver como ver a diferença?
Comece pelo mais simples: uma régua de 30 centímetros não mede 3 metros. Em medição, quando muita gente atinge a nota máxima de um teste, ele perde a capacidade de separá-las; a literatura de estatística chama isso de efeito teto. [5] afirmação da fonte original O problema do teste de IA de quem decide não é errar. É que ele pode não ter como mostrar a diferença que importa.
Conta ilustrativa nossa, com números inventados para mostrar o mecanismo. Três ferramentas fazem uma pergunta de um parágrafo, e todas acertam 9 em cada 10 respostas ou mais: o teste diz “empate”. Entregue agora às três um problema que levaria semanas a uma pessoa e conte quantas o concluem com resultado conferível: 5 em cada 100 tentativas para a ferramenta gratuita, 30 para a paga e 60 para um sistema de agentes. O “empate” era propriedade da régua. A decisão “dá no mesmo, vamos economizar” saiu de um instrumento que não enxergava a diferença.
O mesmo vale para a previsão. Se o teste satura, a previsão de emprego e de produtividade que nasce dele tem uma margem de erro grande e desconhecida, e o sinal do erro não está determinado: quem testou só o plano gratuito tende a subestimar, e quem lê só a fala dos fabricantes tende a superestimar. A conclusão não é que os executivos erram. É que, do jeito que testam, não têm como saber.
Caso hipotético: uma indústria brasileira de médio porte (exemplo nosso)
Parte 4 / O que muda se isso for verdade
O que acontece depois da implicação óbvia? Os efeitos de segunda e terceira ordem
A implicação de primeira ordem é a que todo mundo diz: os executivos precisam usar mais IA. É verdade e é insuficiente. Abaixo, três cadeias de três degraus. Em cada degrau a pergunta é “e depois?”. As fontes dão os ingredientes (o desenho do funil, os números da pesquisa, as objeções do Hacker News). As cadeias são hipóteses da Invisible Work sobre o que isso faz numa empresa, e nenhuma fonte as mede.
Cadeia 1: medir horas de uso não move o teto
Primeira ordem: treinar executivos e medir horas de uso
A resposta natural à média de 1,5 hora por semana é pôr uma meta de uso.
Segunda ordem: as horas sobem, o teto continua onde estava
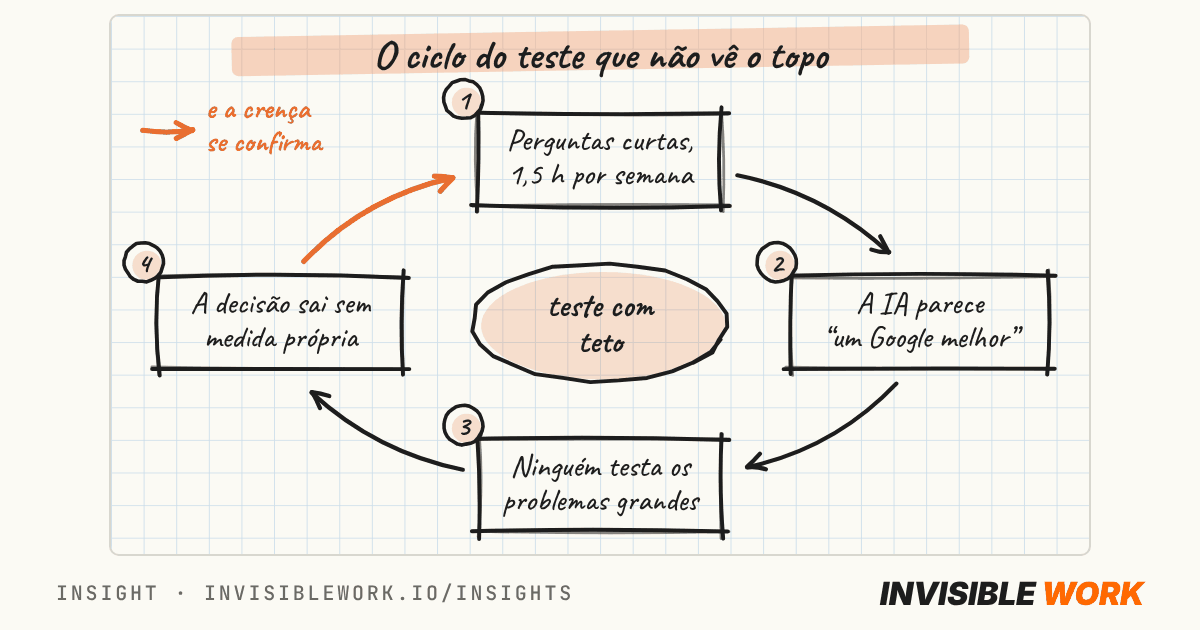
Usar 4 horas por semana com perguntas de um parágrafo ainda não exige do sistema o que ele faz de melhor. A diretoria passa a falar com mais convicção e com a mesma cegueira. O trabalhador americano da pesquisa já usava 1,8 hora por semana, e a média não diz nada sobre o tamanho dos problemas que ele entrega à ferramenta.
Terceira ordem: o uso de baixo valor confirma a crença e o ciclo se fecha
Mais horas de perguntas curtas produzem mais evidência de que a IA é “um Google melhor”, o que reduz o interesse em testar problemas grandes, que é o único lugar onde se veria o topo. Hipótese: a empresa entra num ciclo que se confirma sozinho, com a meta de adoção cumprida e a crença inicial intacta.
Cadeia 2: o sinal fica com quem não decide, e com quem vende
Primeira ordem: os técnicos que veem o topo do funil avisam
Quem usa sistemas de ponta em problemas grandes e verificáveis relata resultados que parecem exagerados a quem testou o plano gratuito.
Segunda ordem: o relato chega filtrado e é lido como entusiasmo
O Hacker News mostra a leitura: “nerds presumem que vale para tudo”. Na empresa, o relato do técnico passa pelo crivo de quem desconfia de vieses de quem gosta de tecnologia. O canal de informação da diretoria passa a ser o fornecedor, a consultoria e a imprensa.
Terceira ordem: a empresa negocia contra quem enxerga mais
Pelas contas de Karpathy, quem vê o que vem são cerca de 5.000 pessoas dentro dos fabricantes. A empresa assina contratos de vários anos e decide estrutura de equipe com base no teste do plano gratuito e na fala de quem vende. Hipótese: a assimetria de informação entre fornecedor e cliente cresce, e com ela a dependência da narrativa do fornecedor para decidir.
Cadeia 3: a previsão vira decisão antes de virar medida
Primeira ordem: a diretoria prevê ganho de produtividade e menos emprego
É o que os executivos da pesquisa declaram: produtividade maior e emprego 0,7% menor em três anos.
Segunda ordem: orçamento e quadro nascem de uma previsão sem medida própria
Planos de contratação, de corte e de investimento passam a depender de um número que ninguém mediu na empresa. Os trabalhadores, na mesma pesquisa, preveem o contrário para o emprego (+0,5%). Quem acerta, ninguém sabe, e Bloom admite as duas leituras.
Terceira ordem: a divergência de expectativas vira custo de confiança
Quem espera cortes tem motivo para não mostrar o que automatizou nem o que a ferramenta consegue, e a empresa perde justamente o canal que mediria a capacidade real. Hipótese: o desencontro entre o que a diretoria espera e o que a equipe espera reduz a informação de que a diretoria precisa para decidir.
Parte 5 / O que fazer com isso
Como fazer um teste de IA com um teto mais alto?
O método abaixo é da Invisible Work e tem uma pergunta por cadeia de efeitos. Complementa o texto “Adoção de IA: o ganho dos 14% que vão na frente depende dos 56% que menos recebem treinamento”, que tratou de quem recebe treinamento, e o “A IA não toma decisões piores”, sobre quem terceiriza o raciocínio. Aqui o assunto é o instrumento de medida de quem decide.
Com que nível de ferramenta e que tamanho de problema quem decide, ou quem informa a decisão, já testou?
Troque a pergunta “quantas horas por semana?” por “qual foi o problema mais difícil que a empresa entregou a um sistema de ponta?”. O teste não pede que o executivo vire usuário avançado: pede que a decisão tenha uma medida. Se a resposta é “perguntas curtas no plano gratuito”, o teto está baixo.
Qual é o seu problema grande, difícil e conferível sem a ferramenta?
Escolha um que hoje leva semanas a alguém, e cujo resultado dá para checar com uma regra clara (um sistema que passa nos casos reais, uma conciliação que fecha, uma análise que bate com os dados). A irregularidade da IA é maior onde o resultado se verifica, e é onde o teste mostra mais.
Quem já fez isso na empresa, com o nível mais forte, e o que mediu?
Peça tempo gasto, retrabalho e erros encontrados na revisão, e compare com o processo atual. O Hacker News lembra o risco: o ganho some se ninguém revisa. Meça com revisão incluída.
Esse conhecimento chega a quem decide sem filtro, e quem o traz tem mandato?
Quem decide deve ler o resultado bruto do teste, não um resumo de fornecedor. E o técnico que viu o topo do funil precisa ter autonomia e um caminho curto até o orçamento, para não usar a ferramenta fora da política.
Quais afirmações da sua estratégia de IA vêm do seu teste e quais vêm de fala de terceiros?
Liste as premissas do plano (ganho de produtividade, corte de quadro, prazo de retorno) e marque a origem de cada uma. As que só têm fonte externa são as que o teto mais ameaça, e as primeiras a testar.
Parte 6 / Limites
O que este texto não prova
O funil de Karpathy é uma estimativa de guardanapo, sem fonte, de um pesquisador entusiasta da tecnologia, e foca em matemática e programação, não em tarefas de gestão, vendas ou relacionamento. Parte do Hacker News contesta que “projetos de meses saiam de uma instrução”, e o texto de Karpathy diz que a capacidade é irregular: o que vale no topo do funil pode não valer no seu problema. A pesquisa da NBER é um documento de trabalho, sem revisão por pares, com respostas autodeclaradas coletadas entre novembro de 2025 e janeiro de 2026, e os executivos e os trabalhadores não são das mesmas empresas; o uso de IA mudou desde então. A média de 1,5 hora não diz o que os executivos fazem com a IA nem com qual ferramenta. Bloom, citado pela Fortune, admite que os executivos podem estar mais certos que os trabalhadores. Não há aqui dado sobre empresas brasileiras. Os números da régua de 30 centímetros, os 90%, os 5, 30 e 60 em cada 100 e o caso da indústria são hipotéticos. As três cadeias de efeitos e o método de cinco perguntas são hipóteses da Invisible Work. O conceito de efeito teto foi lido em enciclopédia aberta, como definição padrão. Nenhuma fonte mede o teto do teste de quem decide: é uma inferência de medição que as fontes tornam plausível, não demonstrada. O que mudaria esta conclusão: testes em problemas grandes e conferíveis de empresas reais em que a ferramenta gratuita e a de ponta tenham desempenho igual; dados mostrando que empresas cujos executivos fazem testes mais ambiciosos não decidem de forma diferente; ou evidência de que as previsões dos executivos acertam.
Parte 7 / Perguntas para levar adiante
O teste que embasa a sua estratégia de IA tem teto?
Seis perguntas para quem responde por resultado, por orçamento ou por operação.
Sobre o teste
- Qual foi o problema mais difícil que alguém da diretoria entregou a um sistema de IA de ponta?
- O teste que a empresa usa para escolher ferramenta de IA separaria uma ferramenta boa de uma excelente?
- A meta de adoção mede uso ou mede o que a ferramenta faz nos problemas grandes?
Sobre o sinal e a decisão
- Quem já viu a IA fazer em dias o que levaria meses tem um caminho curto até quem decide o orçamento?
- Das premissas do seu plano de IA, quais vêm de teste próprio e quais de fala de fornecedor ou consultoria?
- A previsão de ganho ou de corte de quadro tem alguma medida da própria empresa por trás?